项目背景:ArchSight Science 交互科学实验平台(1.6.0 已正式上线并开启商业订阅,约 444 个实验)
结论先行:Grok 的能力比我预期强,但 SuperGrok 30 美元档的周额度比我预期少。
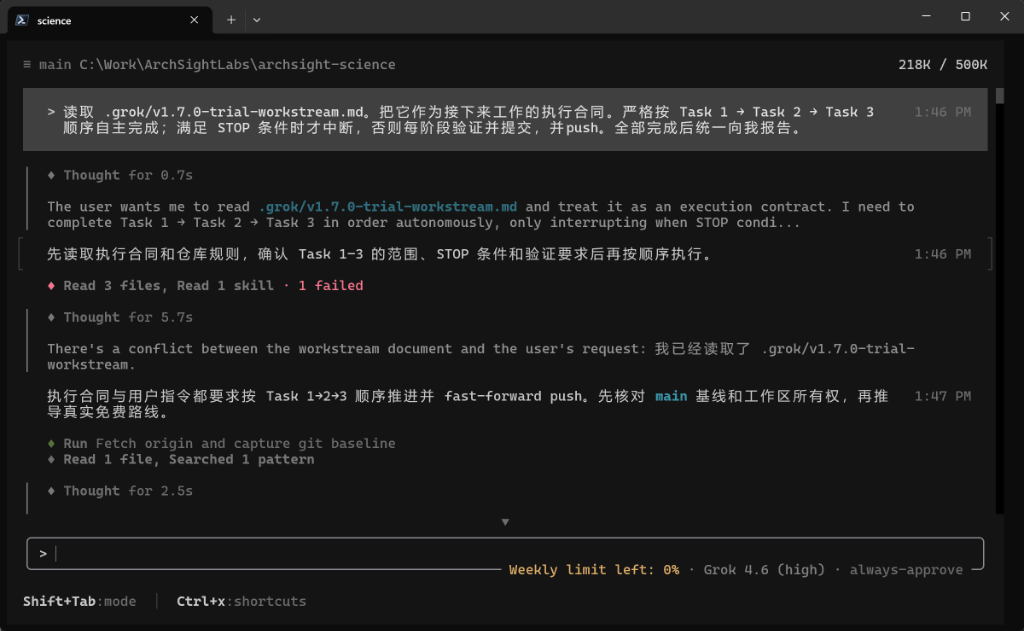
一、我为什么要把 Grok 扔进真实生产仓库?
最近我一直在寻找 Codex 之外的第二条 AI 编程通道。
原因并不复杂:对重度依赖 Coding Agent 开发真实软件的独立开发者来说,公开排行榜上的几分差距,远没有下面这几个变量重要:
实际生产力 ≈ 模型能力 × Agent Harness × 上下文稳定性 × 可用额度 ÷ 人工监督成本
Codex 的综合工程能力很强,但高强度连续开发时,Weekly Quota 会成为非常现实的约束。Gemini 我也长期在 Antigravity 和 IDE 环境中使用,执行明确任务速度很快;至少从我此前的项目实践看,遇到超长上下文架构推演和大型仓库隐性约束时,通常需要更多人工约束与复核。
于是,我利用 SuperGrok 的试用期,对 Grok 4.6 (High) 做了一次深度工程验证。
测试对象不是 Demo,而是我正在持续迭代的 ArchSight Science:
- 数学、物理、化学交互科学实验平台;
- 1.6.0 已正式上线并开启付费订阅;
- 包含约 444 个交互实验与多条正式学习路线;
- 接入微信登录、支付履约、学习进度追踪与专业讲义;
- 有明确的架构分层、自动化测试、发布门禁与多 Agent 协作约束。
不测 LeetCode,不测 Demo,直接把 Grok 扔进这个真实生产仓库。
二、先分清两个 Grok:Bot 做调查,Build 做工程
这次实测主要涉及两个形态。
- Grok Bot(GitHub 原生):直接接入远程仓库,擅长阅读全仓代码、commit 历史与架构文档,更像 Repository Analyst / Architecture Reviewer。
- Grok Build(本地环境原生):运行在本地工作目录,可以读写文件、执行 Shell、运行测试与构建、做浏览器验证并提交 Git,更像 Local Engineering Worker。
多轮任务下来,两者表现出的推理习惯高度相似;但仅凭外部实测,我无法确认它们底层是否就是完全相同的模型实例。
对实际使用而言,更重要的不是猜底层,而是明确分工:
Bot 负责 Investigate,Build 负责 Execute。
三、Grok Bot:它真的能做架构推演吗?
面对只读分析类工具,我最担心的是它只输出“提高代码复用率、补充测试覆盖率”这类正确但缺少操作价值的结论。
所以我设计了四轮针对性测试。
下面的分数只是我基于这一真实仓库样本做的主观工程评价,用来记录不同任务中的表现,不是通用 benchmark。
1. 全仓架构与产品准备度审查(8.2 / 10)
我要求它对整个仓库做一次面向 1.7.0 的准备度扫描。它没有停留在“大文件统计”,而是定位到了 5 个真正影响演进的架构热点:
- 巨型协调器:
ScienceExperience.tsx(超百 KB 的状态聚合); - 核心维护中心:协议、运行目录与主图三件套(
SimulationPlot.tsx承载了 240 多个分支判断); - 知识图谱同源聚合:
knowledge-map.ts承载了三科路线与先修关系的全局映射; - 大型语义场景组件:数理进阶场景的集中堆叠;
- 账号与履约同步契约层。
更有价值的是它对 Multi-Agent 可扩展性 的判断:仓库当前规则可以支持单个实验独立开发,但如果要支撑更多 Agent 并行推进,关键在于 “实验实现可以并行发散,但全局注册面必须严格治理”,并应尽量把跨文件一致性固化成可执行门禁。
2. 反证式架构推演(8.7 / 10)
第二轮我刻意不给它“顺着方案优化”的机会,而是要求:
不要证明这个方案正确,主动找证据证明它可能是错的。
我给出的候选领域模型是:
Subject / Knowledge Building
        ↓
Concept / Knowledge Node
        ↓
Experiment

Learning Route
        ↓
引用 Concept / Experiment
Grok 没有顺着人类假设往下写,而是深入运行时代码寻找反例:
- 运行时
Discipline依然写死数理化三科; - Learning Route 实际依赖底层
unitId,且存在nodeId != unitId的映射; - URL 路由、商业权益判断与知识大厦都与现有分类存在耦合。
最终,它把“Subject 数据驱动”判定为 CONTRADICTED,并把部分前瞻设计判定为证据不足。
这一轮让我确认:它不只是总结已有文档,也能在真实代码中主动寻找与目标架构冲突的证据。
3. Git 缺陷历史考古(9.1 / 10)
ArchSight Science 曾修复过一个 bug:从 full / practice 模式分享实验链接,接收方却可能落到 quick 体验模式。
我要求 Grok 找出相关历史并回答:为什么这个 bug 当初能绕过测试进入候选版本?
它给出的核心判断很有工程价值:
问题不是没有测试,而是测试把错误行为本身固化成了正确合同。
当时实现、测试断言和文档对同一错误行为保持一致,所以局部自动化依然可以全部通过。
Grok 据此提出,真正应该增加的是跨层的:
serialize
   ↓
parse
   ↓
surface
也就是 Roundtrip Contract Test,而不是简单再堆一批 E2E。
这也是整次测试里,我认为最有工程价值的结论之一。
4. 版本规划与价值假设(8.9 / 10)
在不预设版本主题的前提下,我让它独立规划 1.7.0。
它没有直接提议“继续扩充 100 个实验”或“全面重构底层”,而是把候选主题定在 “收费后的可信试用”:1.6.0 商业基础设施已经上线,下一步更值得先验证新用户能否低门槛跑通首次价值闭环。
更重要的是,它明确区分 FACT 与 HYPOTHESIS,没有把未经数据佐证的用户流失推测写成既成事实。
Grok Bot 综合评分:8.8~9.0 / 10。
在这次项目样本中,它已经足以承担方案落地前的架构红队、仓库调查和盲区排查工作。
四、Grok Build:代码能不能真正进入 main?
Bot 再聪明,也不是我决定是否长期使用 Grok 的核心依据。
我真正想知道的是:
Codex 额度不够时,Grok 能不能直接进入同一个仓库继续干活?
对话框里的代码再漂亮,跑不通也没有意义。真正有辨识度的是:能否理解既有工程约束、完成修改、通过测试与构建,并最终让成果进入 main。
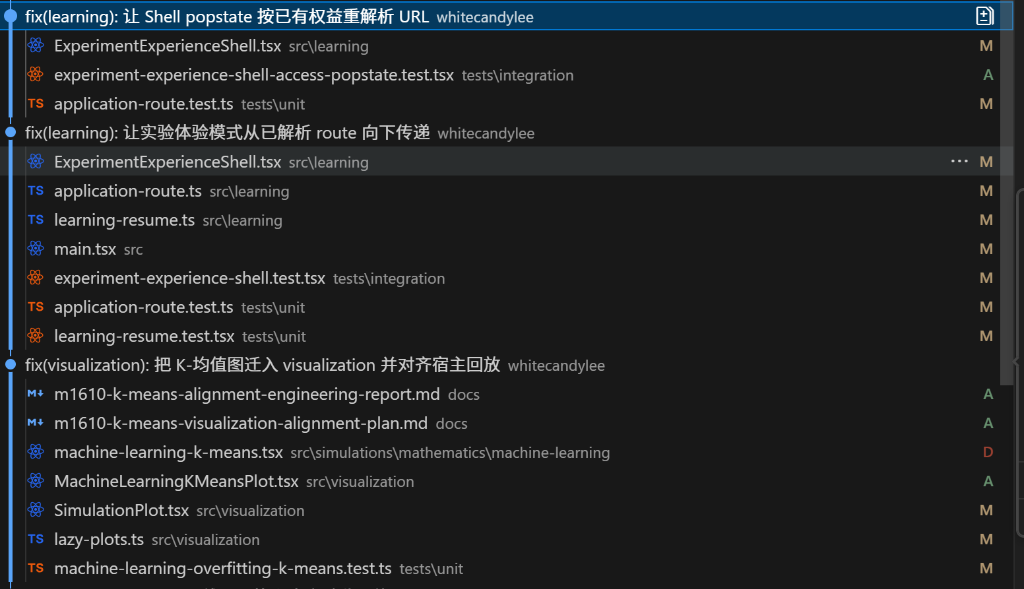
战役 1:自主发现问题并整改 M1610 K-means(9.1 / 10)
我没有告诉它改哪个文件,只要求它从全仓自主挑选一个不符合当前工程规范的实验,并完成一致性修复。
它最终选择了 M1610 K-means。
主要动作包括:
- 将 React 组件从底层
simulations/迁入visualization/表现层; - 复用
SciencePlotSurface、CartesianAxes、SamplePlaybackControls; - 补齐宿主连接测试;
- 检查明暗主题;
- 跑通 Production Build。
最让我认可的是,它没有为了做出更显眼的动画,在 React 组件里重新计算 K-means,而是继续把 SimulationRunRecord 作为科学结果的真值边界。
这个改动经过后续复核后真正进入了 main。
战役 2:单一真值收敛,以及一次真实的遗漏(9.1 / 10)
第二个任务里,Grok 负责收敛平台体验模式(quick / full / practice / theory)的解释逻辑,抽象出统一的 experimentExperienceModeForRoute(route)。
方向是对的,但第一次实现留下了一个真实的权限上下文边界缺陷。
我独立 Review 时发现:浏览器触发 popstate(前进/后退)后,ExperimentExperienceShell 会重新解析 URL,但当时没有传入当前用户的 accessContext。在 freemium-v1 下,这可能让付费实验按匿名上下文重新判定,进而导致本地 mode / unitId 状态与真实权益解析结果发生偏差。
我没有直接给补丁,而是把风险指给 Grok:
不要假设这是 bug,先写测试证明。
它随后补充了覆盖 pass-active、trial-active、mode、unitId,以及 main + Shell 双 popstate listener 的回归测试,确认问题后再完成修复。
这反而让我对它更有信心:
好的 Coding Agent 不是第一次实现永远不犯错,而是被指出边界风险后,能不能重新证明问题、修正实现,并建立防复发证据。
战役 3:长时间自主工程工作流(8.9 / 10)
接下来我不再一条条喂任务,而是直接给它一份包含三项子任务的 Markdown 执行合同,测试长程自主性:
- 永久免费路线闭环审计:在匿名
freemium-v1模式下运行浏览器并交叉核验全仓,最终确认 8 条真实免费路线。它发现了物理免费路线默认展示不友好、文案自动拼接导致“当前当前计算值”、路线进入三分钟体验后下一步丢失 journey 上下文等问题,并把修改限制在少量高价值范围内。 - 激活漏斗与可观测性(Analytics):Science 并不掌握真实支付成功结果,成交发生在 Cloud。Grok 没有把权益刷新或订单展示包装成
Purchase Success,只接入已有plans_viewed事件表示用户进入套餐购买入口,而且没有携带用户身份和实验输入等不必要数据。这一轮体现了较好的 Bounded Context 意识。 - 高曝光实验动态反馈(DH-008 审计):它只抽查高曝光免费实验,对已经证明存在反馈缺陷的 P0101、C0101 做了修复,对表现正常的实验保持不动。没有问题时敢于不写多余代码,这是一种宝贵的工程克制。
这一轮也暴露出一个不足:P0501 当时证据仍不充分,但 Grok 已提前把它纳入 observation playback 修改。代码后来证明方向没有问题,但在当时的证据状态下,这仍然超出了“只修已经证明的问题”这一执行约束。
五、它哪里还不够成熟?
如果只看前面的成功案例,很容易高估一次实测的普遍性。连续高强度使用后,Grok 同样暴露出了几个明确边界。
1. Long-running Process 管理不够成熟
测试期间,Grok 执行 npm run dev 启动 Vite 开发服务器,却把这一常驻服务当成普通前台 Shell 命令同步等待。
结果当前执行循环被阻塞接近 40 分钟,后续输入全部进入 queue。
更成熟的 Coding Agent 在处理 Dev Server、Docker 等长期进程时,应该倾向于:
后台启动
→ readiness check
→ browser
→ 继续 Agent loop
这个细节看起来不大,但在长时间自主执行中会直接影响吞吐和可控性。
2. 高风险商业权限边界仍需要第二次独立 Review
前面的 popstate 问题说明:在身份认证、Entitlement、支付、账号切换、数据迁移等高风险边界上,即使整体架构方向正确,也可能遗漏隐式上下文。
因此我的使用原则不会是“Grok 写完就直接信任”,而是:
普通 repo-level 工程任务可以让它自主完成;涉及身份、权益、支付和数据迁移时,仍保留第二强模型或人工独立 Review。
3. 真正影响订阅决策的变量:Weekly Limit
真正改变我订阅判断的,不是某个局部 bug,而是用量面板上的周额度状态:
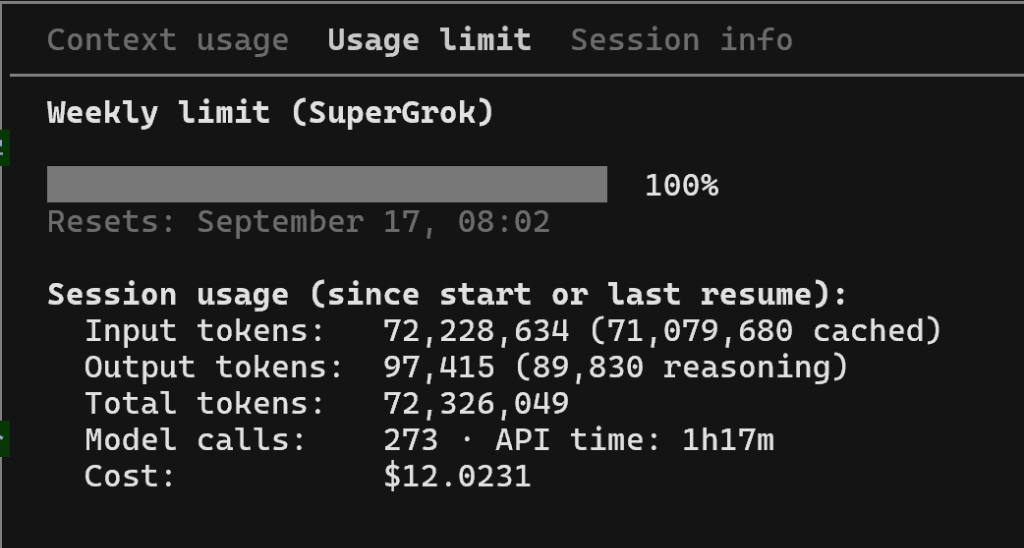
Weekly limit (SuperGrok): 100%
从面板可以观察到几组很有意思的真实数据:
- Reasoning 占比较高:该次会话累计输出 97,415 tokens,其中 89,830 tokens 被系统标记为 reasoning,占比约 92.2%。这只能说明当前统计口径下,大部分 output token 被归入 reasoning;不能进一步证明每一个 reasoning token 都是在做“深度代码推演”。
- 上下文缓存命中率很高:会话累计 input 为 72,228,634 tokens,其中 71,079,680 tokens 显示为 cached,约 98.4%。因此不能把 7200 多万 input tokens 理解成模型反复读取了同等规模的全新上下文。
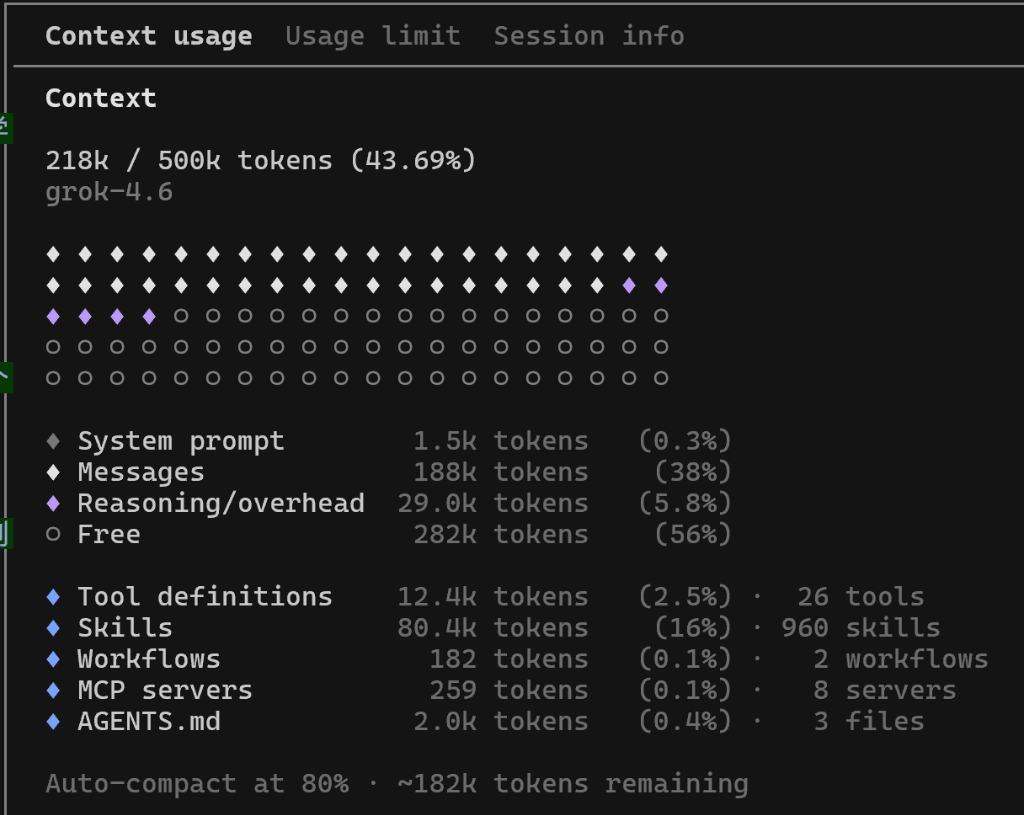
- 环境上下文本身并不轻:当时 Context Usage 为 218K / 500K;其中 Messages 188K,Skills 项显示 80.4K tokens、960 skills,Tool definitions 为 12.4K。这也提醒我,大量全局 Skills 并非没有上下文成本,后续更适合按项目和场景裁剪。但这些数字本身不能直接推导出 weekly quota 的具体计费权重。
- 周额度达到上限时的会话数据:该会话记录为 273 次模型调用、API time 1h17m、界面统计 Cost $12.0231;与此同时,
Weekly limit (SuperGrok)已显示为 100%。这里必须强调:Session usage与Weekly limit是两套统计口径,不能把 273 次调用或 $12.02 直接等价成 SuperGrok 的官方固定周配额。
因此,这组数据真正能支持的结论只有一个:
在本次高强度真实工程负载下,SuperGrok 30 美元档的 weekly pool 消耗很快;对持续高强度 Agentic Coding 用户,它并不适合作为不间断的全天候第二主力。
六、综合评价:Grok 已经进入我的生产工具链
下面仍然只是基于 ArchSight Science 这一真实项目样本的主观工程评价。
Grok Bot:8.8~9.0 / 10
- 代码库全局理解:9.0
- 架构反证与对抗推演:8.8
- Git 历史考古与根因分析:9.1
- 宏观版本规划:8.9
Grok Build:8.5~9.1 / 10
- 架构分层遵从度:9.2
- 最小修改边界:9.3
- 单元测试与测试意识:9.0
- Git Hygiene:9.2
- Review 后的纠错能力:9.2
- 常驻进程管理:约 7.0
- 高风险权限与商业边界:7.5~8.0
如果只看能力,我已经愿意长期使用它。
真正限制它成为“第二个 Codex”的,不是代码质量,而是当前 30 美元档在我的使用强度下能持续多久。
七、这次还验证了另一件事:多个 Agent 可以直接接力
这次多模型切换还验证了一个对我很实用的工作方式:Codex、Grok、Gemini 直接操作同一个本地 Working Tree。
前一个 Agent 额度耗尽或完成阶段性任务后,下一个 Agent 可以通过 git status、git diff 和当前文件直接看到最新现场,就地接力。
对一人开发、多模型轮换的场景而言,这减少了频繁切换分支、合并和跨 Agent 重建上下文的成本。
当然,这不是说共享 Working Tree 普遍优于传统多分支。它成立的前提是:
- 同一时间避免多个 Agent 争抢同一核心文件;
- 不随意回滚其他 Agent 的已有修改;
- 不使用
git add .等粗粒度暂存; - 阶段结束后必须做统一的全量收敛验证;
- 正式发布仍以干净 main、完整证据和 immutable tag 为边界。
对于多人团队,feature branch / PR 仍有自己的治理价值。这里讨论的是我当前的一人多 Agent 开发方式。
八、我的当前工具分工
基于这次真实项目实测,我目前的判断是:
- OpenAI / Codex:核心主力。 复杂架构、关键实现和高风险问题仍优先交给 Codex。它的价值主要是工程判断上限,而不是单纯追求“大吞吐量”。
- SuperGrok 30 美元档:高质量备用 / 突击通道。 我倾向继续保留,但不会把它当成全天候第二个 Codex。更适合 Codex 额度空窗期、repo-level 中大型整改、架构反证和高价值修复,把有限 weekly pool 用在真正需要高推理的地方。
- Gemini:高吞吐明确任务通道。 继续利用 Antigravity 熟悉的工作流,承担需求明确、风险可控的常规模块迭代和内容处理。
这不是永久结论,而是这轮实测后的当前判断。
真正决定长期分工的,仍然是:
单位监督时间内,谁能留下更多真正进入 main 的有效成果。
结语
如果把这次实测浓缩成一句话:
Grok 的能力比我预期强,但额度比我预期少。
对于 Coding Agent,我更关心的不是它在排行榜上排第几,而是:
在真实代码库、真实架构约束、真实测试门和真实额度限制下,它到底能替我完成多少工程工作?
这次 Grok 已经留下了真正进入 main 的代码,也留下了被 Review 找出问题、再由它自己补测试修正的完整过程。
对我而言,这类证据比一次漂亮的 benchmark 分数更有参考价值。