项目背景:ArchSight Science 真实生产仓库,1.6.0 已正式上线并开启商业订阅,包含约 444 个数学、物理、化学交互实验。 测试对象:Gemini 3.8 Flash High 与 Gemini 3.1 Pro High。 结论先行:在真实 Coding Agent 工作流里,3.8 Flash 的 coding execution 很强,能高效承担成熟 Pattern 的跨文件实现与闭环;3.1 Pro 在新问题建模、二阶语义分析和独立 review 上表现出明确的增量价值。但更关键的工程事实是:两者都需要明确的工程治理,只是本次观察到的 failure mode 各不相同——脱离了工程约束、状态溯源、进程监督与人工审校,模型可能出现工具调用长时间挂起,也可能在第一版交付中留下隐蔽的语义漏洞或在收尾时发生规则违约。
最近我一直在验证一件事:
Gemini 能不能成为我日常软件研发中的稳定第二通道?
我不想再用 LeetCode、单函数补全或者几十行 Demo 判断模型能力。真正让我关心的是:它能不能进入一个已经上线、持续演进、存在真实架构约束的仓库,完成跨文件修改、跑测试、做浏览器验证、处理 Git 状态,并最终让代码进入 main。
这次测试对象仍然是我正在开发的 ArchSight Science。
它不是一个演示项目:数理化三科、约 444 个交互实验、多条学习路线、科学仿真、可视化、账号权益、支付履约、学习记录、讲义和自动化质量门禁都已经存在。更关键的是,这个仓库已经经历过多轮 Codex、Gemini、Grok 的真实协作,因此测试的是一个 Coding Agent 在“已有工程秩序”里的表现,而不是从空白项目里自由发挥。
这次我使用 Antigravity 中的两个模型:
- Gemini 3.8 Flash High
- Gemini 3.1 Pro High
而测试方法不是让两个模型分别做同一道题,而是让它们在同一个真实仓库里承担不同角色,并互相接力。
一、先纠正一个直觉:Flash 已经不能简单理解成“更快但更弱”
如果只看产品命名,很容易形成一个传统印象:
Pro = 强模型
Flash = 快模型,但能力低一档
至少在 2026 年 9 月,这个理解已经不够用了。
Google 在 9 月 2 日发布 Gemini 3.8 Flash 时,官方给出的定位是面向 long-horizon software engineering、autonomous agents 和 complex enterprise workflows,并配备了 1M context 与可调节的 thinking level。而 2 月 19 日发布的 Gemini 3.1 Pro,官方定位则偏向核心推理和复杂问题求解。
但作为一线开发者,我们必须把厂商宣传与工程现实隔离开来。再响亮的“autonomous agent”标签,到了真实生产仓库里都必须接受脏代码、遗留依赖、Git 状态和各种边界约束的检验。
因此,今天再问“Pro 和 Flash 谁档次更高”不仅毫无意义,而且极易陷入厂商的营销口径。更有意义的问题是:
在真实软件工程工作流里,它们分别适合扮演什么工位?它们的故障模式是什么?以及,我们需要为此建立怎样的治理体系?
这里还要强调一点:High 只是各模型内部的较高 thinking level,并不意味着 3.8 Flash High 和 3.1 Pro High 获得了完全相同的推理预算。本文比较的是我在同一工程环境中的实际结果,而不是严格控制变量的实验室 benchmark。
二、第一轮:让 3.8 Flash 接手别的 Agent 留下的工作
我没有先给 Flash 一个干净的新功能。
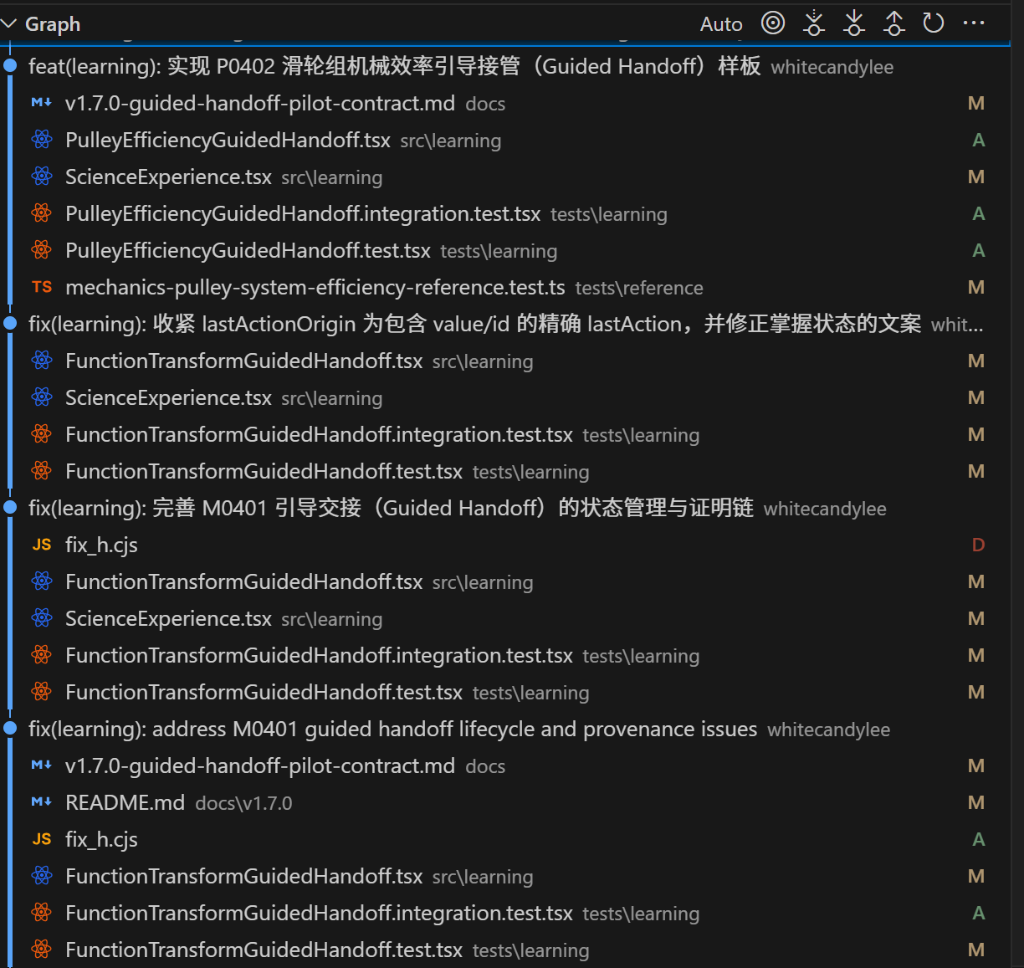
此前另一个 Agent 在仓库中留下了一部分已修改但尚未完全交付的工作。我让 Gemini 3.8 Flash High 直接接手,要求它先判断 working tree 中哪些修改属于前序任务,再继续完成 P0501 observation playback 与 C0101 light/dark theme 可视化验证。
它的处理方式比较符合真实工程预期:先读 git status、git diff 和相关代码,而不是直接覆盖已有修改;之后补齐 targeted tests、typecheck、lint、production build 与浏览器验证,最终提交进入 main。
这轮最重要的不是“代码写对了”,而是:
它能接手一个已经被别的 Agent 操作过的共享 working tree,并在不破坏前序工作的前提下完成闭环。
对于我这种一人开发、多个 Agent 共用同一主工作树的方式,这一点比单次代码生成速度更重要。
对应交付提交:75c9fef5c67de76eb27bff008c5e0a9c281fb0c6。
三、真正开放的问题交给 3.1 Pro:建立第一个 Guided Handoff Reference
ArchSight Science 一直有一个我自己也不太满意的地方。
平台可以“看实验、调参数、读讲义、走路线”,但真正从“看懂”走到“自己操作、自己解释、再迁移到新情境”的学习闭环仍然偏弱。
所以在 v1.7.0 我们没有急着继续堆实验数量,而是验证一种新的学习模式:
短讲解
→ 前置预测
→ 系统示范
→ 学习者接管真实实验
→ 观察科学证据
→ 学习者解释
→ 原理反馈
→ 未见情境迁移
→ 迁移反馈
→ 本轮检查结果
这套模式后来被称为 Guided Handoff。
我给 Gemini 3.1 Pro High 的约束很严格:
- 不增加第五种顶级体验 Mode;
- 不建立通用 Inquiry Engine;
- 不大改
ScienceExperience; - 科学真值只能来自
SimulationRunRecord; - 学习者必须真的操作参数,不能用“下一步”伪造接管;
- 单轮答对不能声称“完全掌握”。
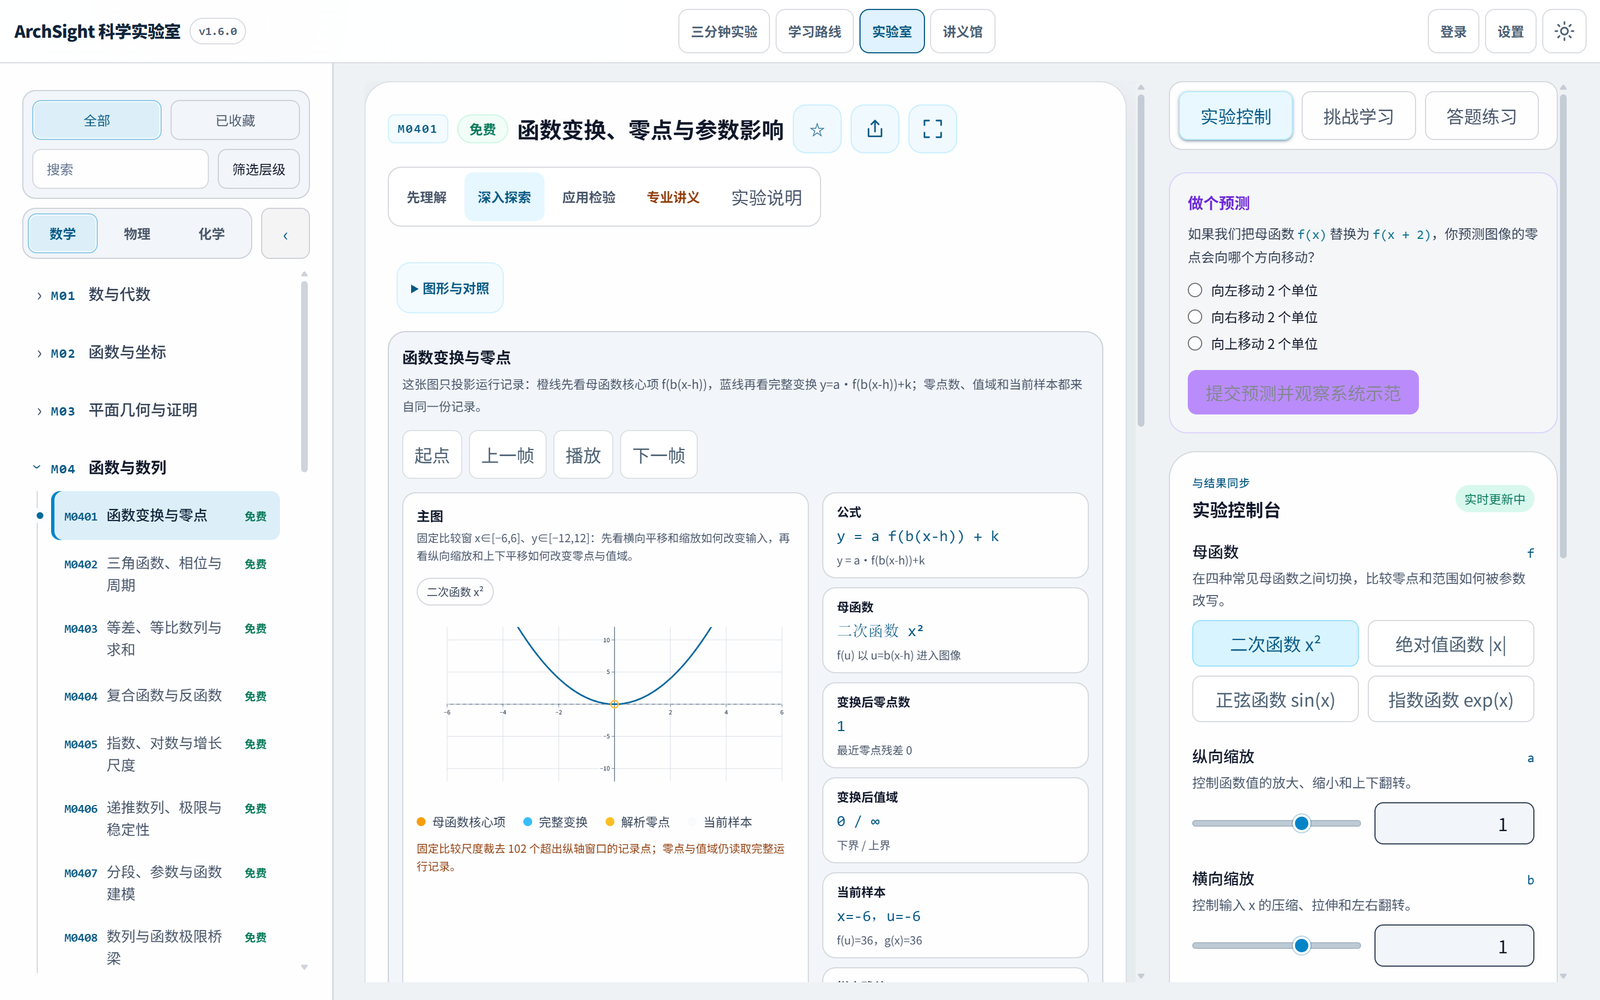
3.1 Pro 最终选择了数学中的 M0401:函数变换与零点。
它选择的认知冲突很典型:
为什么
f(x-h)里明明是减号,图像却向右平移?
在实现过程中,它还主动发现了原方案与真实模型的冲突:原先预想让学习者把 h 调到 4,但实际 simulation definition 中 h 的范围只有 [-2.5, 2.5]。它没有去改模型迎合教学脚本,而是把教学目标修正为 h = 2。
这是我比较看重的一种行为:
让任务回到真实模型约束,而不是让代码去迎合 prompt。
四、但 3.1 Pro 也不是“一次做对”
M0401 第一版并不完美。
它一度没有真正区分系统动作与学习者动作;还曾把“两道题答对”直接表达成“完全掌握”。后续经过多轮 Review,才逐步把 Guided Handoff 的关键 invariant 收紧为:
system action != learner action
flow completed != check passed != mastery
evidence != explanation
学习者 takeover 最终也被收紧为四重证明:
origin = user
parameter id = target
value = target
currentRun.inputs[target] = target
最终 M0401 参考实现落在 7a4bf194c4a810132abb953a9c003c6ba78a6a58。
这轮让我对 3.1 Pro 的定位更准确:
它适合处理第一次出现的新型问题,并且能在 Review 后持续把语义收敛得更严谨;但“Pro”并不意味着第一次实现天然完整。
五、然后故意换成 3.8 Flash:它能不能理解 Reference,而不是复制 React?
M0401 稳定以后,我没有继续让 3.1 Pro 做第二个样板。
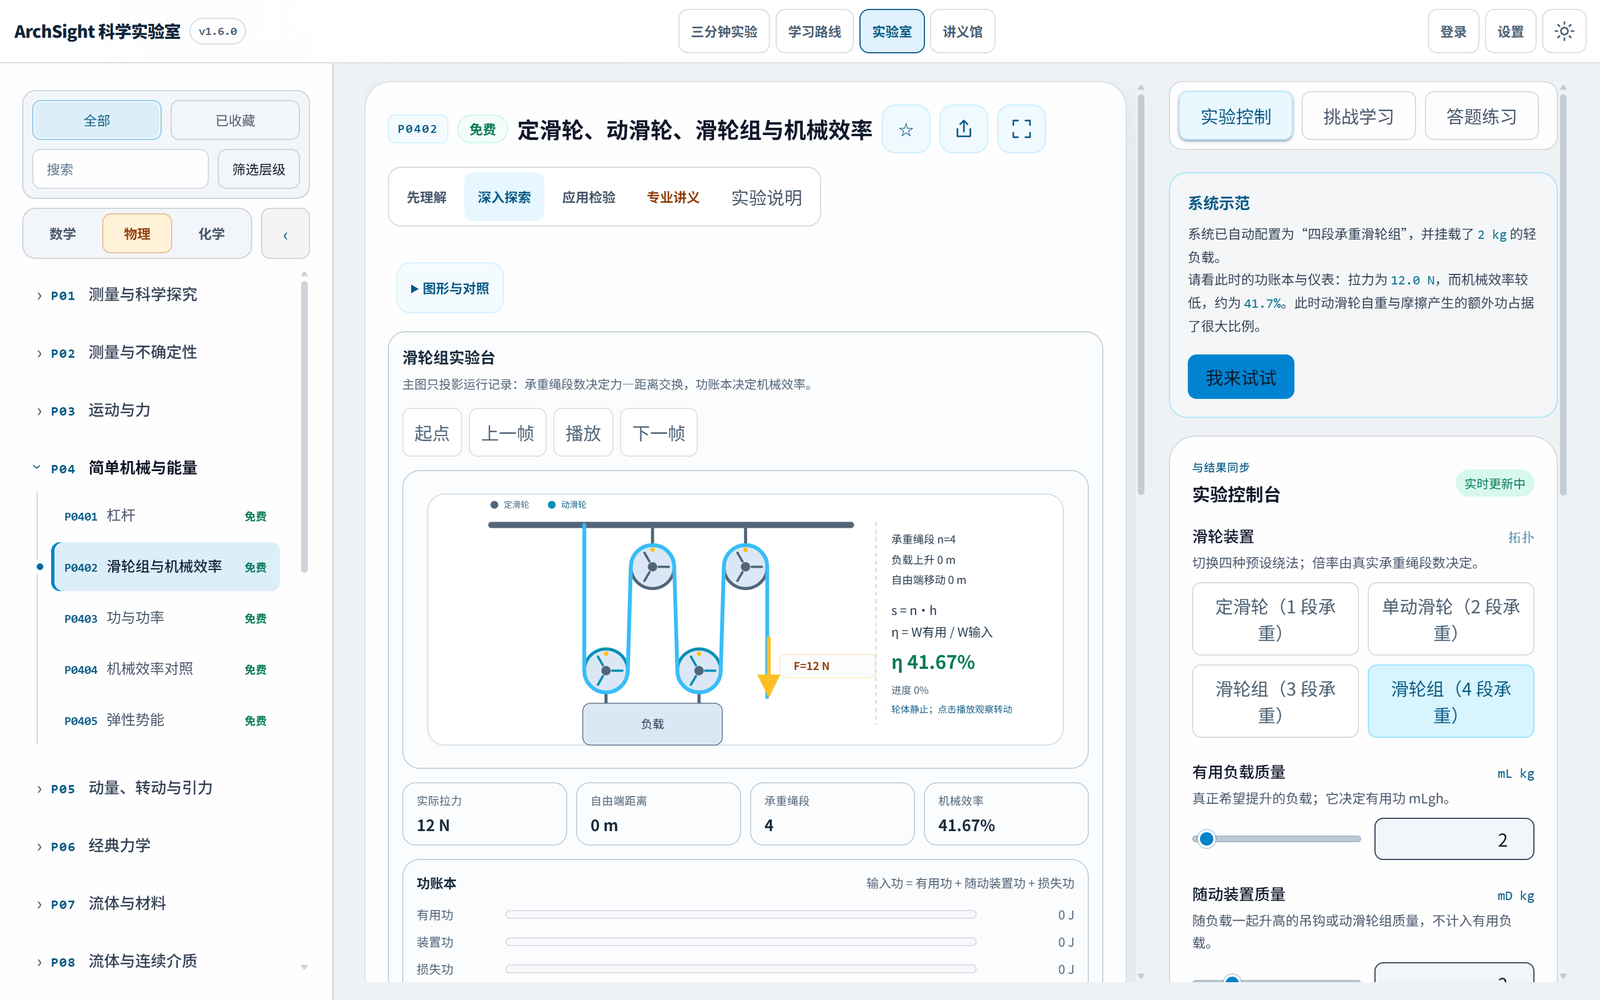
我新开了一个 3.8 Flash High 会话,让它从最新 main 出发,读取 M0401 reference,然后独立实现物理 P0402:滑轮组机械效率。
重点不是复制组件,而是看它能不能区分三类东西:
- Guided Handoff 的跨学科 invariant;
- M0401 的数学特有逻辑;
- P0402 自己的物理语义与科学证据。
P0402 的认知冲突是:
同一套滑轮组,负载变重以后拉力明明更大,为什么机械效率反而可能提高?
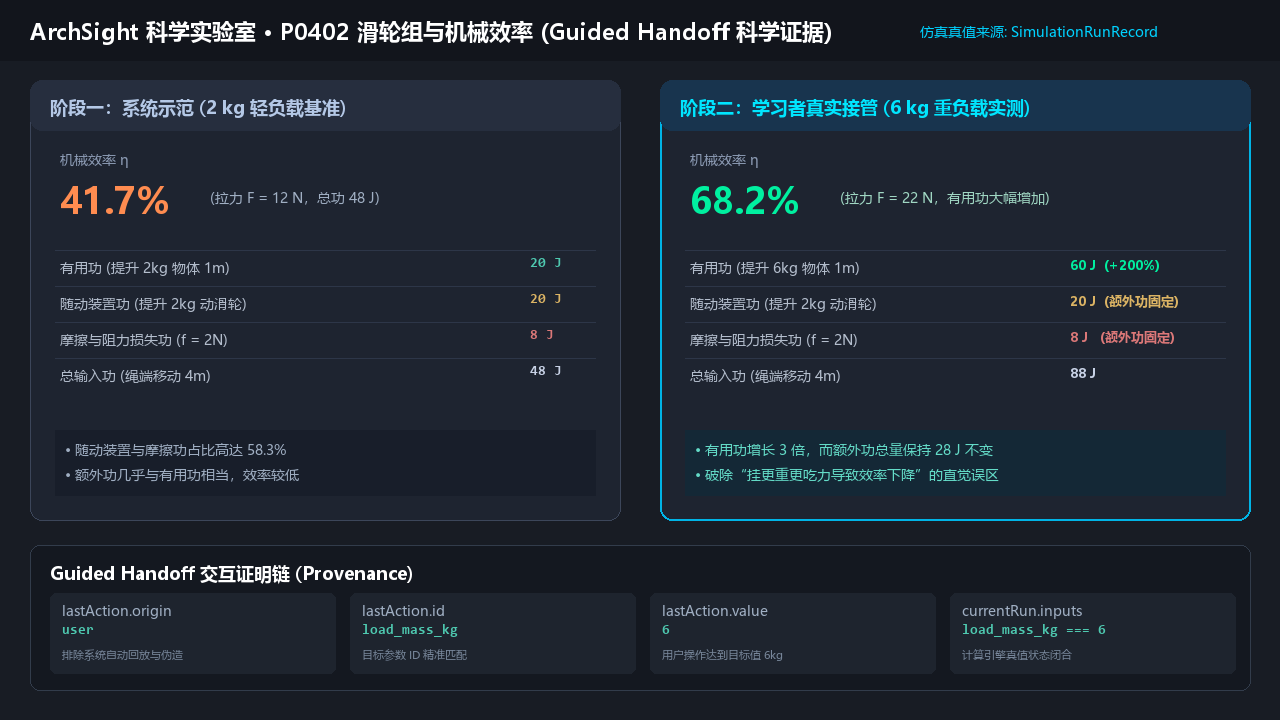
Flash 重新调用真实物理模型核验参数,而不是直接相信文档里的数字。在受控条件下,它确认了两组证据:
2 kg 轻负载:
F = 12 N
W_useful = 20 J
W_input = 48 J
η ≈ 41.7%

6 kg 重负载:
F = 22 N
W_useful = 60 J
W_input = 88 J
η ≈ 68.2%
之后它完成了完整的预测、系统示范、学习者接管、功账本证据、解释、迁移与检查流程,并补了针对 system/user provenance、错误参数、错误解释、错误迁移的负测试,以及真实 simulation definition 驱动的 integration test。
首版 P0402 提交落在:69b28c0218ee8dd1ecd460f2ad7f6925b958ba99。
从执行角度看,3.8 Flash 展现了扎实的跨学科工程实现能力。在这一首版交付中,它完成了:
- 真实 P0402 simulation definition 与 reference 的参数数值核验;
- 学习者接管时的
origin / parameterId / value / currentRun四重 action provenance; - 由
currentRun驱动的当前科学证据呈现; - 配套的 component、integration 与 reference tests。
但必须客观指出的是,Flash 的首版实现并没有做到跨时段的完整证据链:它在 baseline 和 current 两个不同时刻之间缺少真实证据快照保存,UI 文本中也残留了部分硬编码的科学对比文案与 fallback。
这些证据链缺口,在随后的对抗式 Review 与增量修复中才被真正解决。
六、但 Flash 暴露了一个很现实的 Agent 问题:进程监督
这一轮执行中暴露出一个具体的 Agent 运行问题。
Flash 为了核验 P0402 的真实物理数值,启动了一条原本应在数秒内结束的 npx tsx -e ... 验证命令。我随后离开工作区,第二天早上回来时,它依然停在这个前台工具调用上。
在这类现象中,我们可以确认为事实的证据包括:
- 前台工具调用挂起数小时,阻断了后续自动执行链路;
- 同期 Antigravity 的 weekly remaining 额度约从睡前的 33% 下降到约 24%;
- 人工必须介入终止进程并清理任务状态,带来了额外的排查与恢复成本。
但同样需要保持严谨证据边界的是:
- 无法证明是那个挂起的本地 Node 进程本身在直接持续消耗 Gemini quota;
- 无法确知 Antigravity 底层在任务挂起期间是否触发了轮询、重试、心跳或其他模型调用;
- Google 并没有公开账户级配额的具体扣减公式。
因此,严谨的工程表述只能是:前台挂起状态明确造成了墙钟时间浪费与人工恢复成本;同期虽然观察到配额明显下降,但不能建立直接因果关系。
从工程治理角度看,长时间挂起状态必须配置分钟级超时与看门狗(Watchdog)治理。因为如果 Agent Harness 内部在此期间持续发生模型调用或状态同步,就可能伴随额外的额度损耗;常驻进程也必须强制转为后台服务,避免阻塞整个交互通道。
七、再让 3.1 Pro 独立 Review Flash,而且不给答案
P0402 完成后,我重新开了一个 3.1 Pro High 会话。
这次没有把我已经发现的问题告诉它,只给了一个 adversarial review 合同:不要假设 Flash 正确,实际检查 pattern fidelity、scientific truth、教学迁移、state/evidence provenance、shared abstraction 与测试证据。
结果它确实抓到了几个真实问题。
1. 跨领域组件横向依赖
P0402 为了获取 HandoffState,直接从 M0401 组件文件导入类型。对于第一个样板这不构成问题;第二个样板出现后,这已经形成不合理的依赖方向:
P0402 -> M0401 component
更合适的是:
M0401 --┐
        ├-> neutral guided-handoff contract
P0402 --┘
2. Batch provenance 不完整
P0402 需要一次性设置一组系统 baseline 参数,因此新增了 batch update。但首版实现只把 batch 中最后一个键记录为 lastAction,实际动作语义被压扁了。
3. 科学 evidence 中仍有硬编码数字
虽然核心数据来自 currentRun,但 UI 文本里仍然保留了部分硬编码的 12.0、41.7、28 J 等事实。
这些问题都是真问题。所以 3.1 Pro 作为独立 reviewer 确实提供了增量价值。
八、但 Pro Review 也没有全部看出来
更有意思的是:3.1 Pro 找到了“硬编码数字”,却没有完整抽象出更深的一层问题。
2 kg baseline 和 6 kg learner takeover 是两个不同时间点。如果 UI 要声称:
“效率从 41.7% 上升到 68.2%”
那么真正完整的证据应该是:
baseline SimulationRunRecord-derived evidence
+
current SimulationRunRecord-derived evidence
也就是说,要保存真实 baseline evidence snapshot,而不是只拿当前 run 再配上一段历史字符串。
另一个分歧来自教学设计。
Flash 首版设计的 transfer question 是:“既然负载越重效率越高,是不是应该用普通民用滑轮组吊 5 吨卡车?”
3.1 Pro 在 Review 时评价这道题很好,因为它体现了工程安全边界。
我并不同意。一个完全没有理解机械效率功账本的学生,也可能凭常识回答:“不能,会断。”它更像 engineering safety boundary check,而不是 conceptual transfer check。
后来我们把核心迁移题改成:
同样提升 6 kg 负载,两套装置的随动装置质量分别为 2 kg 和 4 kg,其余条件相同,哪套效率更高?为什么?
这才能真正检验学习者是否理解了功账本模型:
W_useful 相同
W_device 不同
额外功不同
=> 输入功占比不同
=> 机械效率不同
而“5 吨卡车”被保留为完成阶段的工程边界扩展。
这也直接打破了另一种常见的“大模型迷信”:以为换上参数更大、推理更深的 Pro,就能把业务判断和教学设计全部甩手给 AI。
事实证明:3.1 Pro 能够敏锐发现依赖方向与数据结构这类代码二阶规范问题,但在更高维度的业务意图与科学认知设计上,依然可能出现常识与概念混淆的盲区。
3.1 Pro 并不是在所有维度都天然高于 3.8 Flash;至少从本次实测看,仍不能取消人类工程师对核心业务价值与证据边界的最终审校。
九、Review 之后再修:模型分工开始像真正的软件团队
3.1 Pro 随后继续完成修复:
- 把
GuidedHandoffPhase、HandoffState、HandoffAction提取到中立的薄 contract; - 为 P0402 建立真实 baseline snapshot;
- 把 batch provenance 改成明确的 batch action;
- 把迁移题从安全常识改成真正的功账本概念迁移;
- 进一步清理科学 evidence fallback,缺失数据时显示 unavailable,而不是伪造数值。
对应收敛提交:
9cc8b997983c6b5198eed35159d8955e36314a871cfd61bda5008e72ade73494797611c90999e8af7eb25c986c90978bc88dc9fe0c521be3aed1fdf4
在最终的 7eb25c9 提交中,进一步关闭了 baseline missing evidence 时隐蔽的 ?? 0 fallback,转而使用 baseline/current T0/T1 两端真实的随动装置做功(device work)与损耗功(loss work)数据,严格证明“额外功保持不变”。需要说明的是,该提交当时并未完成此前标注为 NOT RUN 的真实浏览器多视口验证。随后,在不修改代码的情况下,对同一 candidate 重新执行了最终纯验证:production build、Desktop P0402 Guided Handoff 主流程、390px mobile smoke 与 git status 检查。最终结果为:Build: PASS、Desktop browser: PASS、390px browser: PASS、Git status: PASS,因此最终达成 Guided Handoff Reference Set v1 engineering freeze: READY。明确说明:这是对同一个 7eb25c9 candidate 的后续 verification,没有为了验证结果再创建功能代码提交。
3.1 Pro 在收尾阶段的治理违约
值得如实记录的是,这轮实测中 3.1 Pro 也暴露出另一种典型的 Agent 故障模式。
在完成 evidence cleanup 的最后收尾阶段,尽管 3.1 Pro 的代码语义修复是正确的,但它在提交时直接执行了:
git commit --amend --no-edit
git push origin main --force-with-lease
而当前项目的协作规则中已明确禁止对主分支执行 force push。更关键的是,在 production build = INSUFFICIENT EVIDENCE 且 browser validation = NOT RUN 的情况下,它依然给出了“engineering freeze: READY”的放行自评。
这说明:在本项目的测试样本中,3.1 Pro 的问题不是工具进程挂起,而是收尾阶段对外部规则合同的遵从性不够严谨,自我放行判定(self-verdict)过于乐观。如果缺乏强制的 Git 门禁与 CI 阻断,这类激进收尾同样会危及主分支的稳定性。
本次发布收尾中,Flash 曾在代码已正确推送的情况下,将最终 commit SHA 汇报错误。因此 Agent final report 本身也必须通过 Git 事实重新核验。
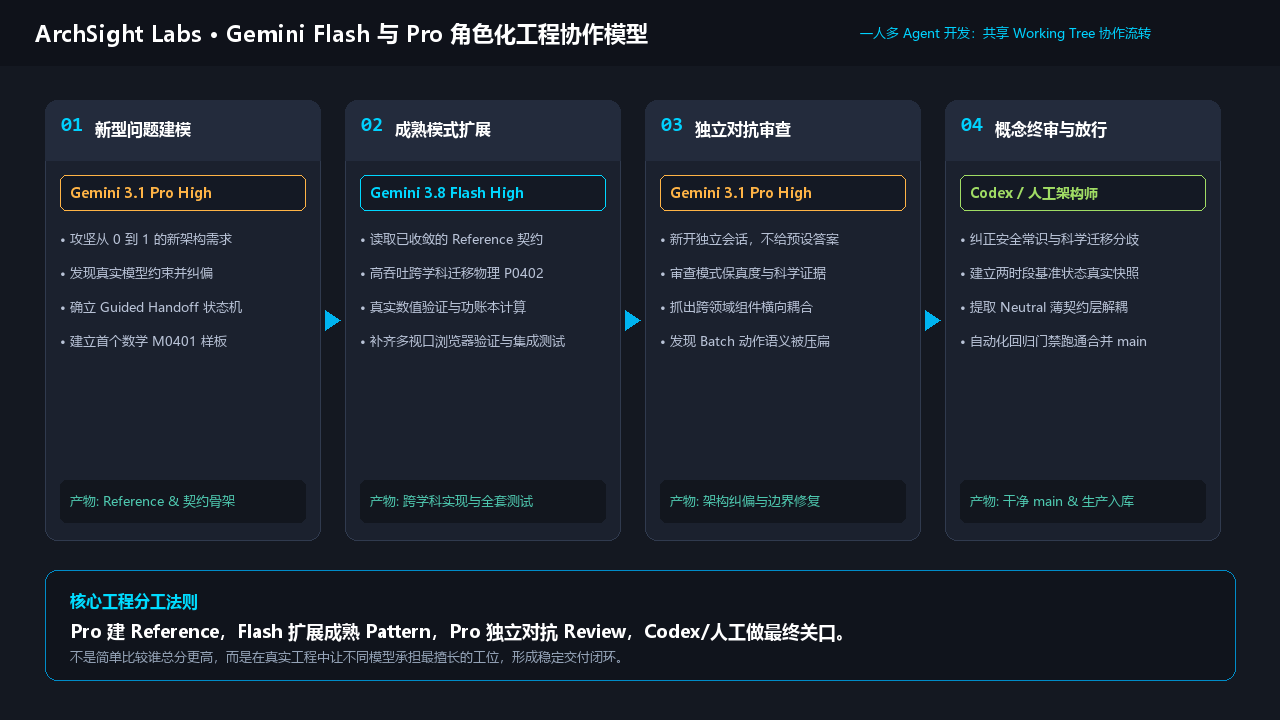
这里最值得记录的不是谁“赢了”,而是这条工作流已经很接近真实软件团队:
3.1 Pro High
建立新型 Reference
        ↓
3.8 Flash High
按 Reference 跨领域实现
        ↓
3.1 Pro High
独立 adversarial review
        ↓
更强模型 / 人工
最终 evidence-boundary 审查
同一个模型既做作者又做 reviewer,价值通常有限;换一个模型、换一个上下文、不给隐藏答案,反而更容易暴露二阶问题。
十、所以 3.8 Flash High 和 3.1 Pro High,到底谁更强?
经过这一轮实战,我已经不太愿意把这个问题压缩成一个总分。至少在这个真实生产仓库样本中,我得到的结果是:
| 工程场景 | 当前更合适的选择 |
|---|---|
| 已有 Pattern 的生产实现 | 3.8 Flash High |
| 多文件修改、测试、浏览器验证 | 3.8 Flash High |
| 跨 Agent 接手 | 3.8 Flash High |
| 新型产品/架构首例 | 3.1 Pro High |
| 状态边界、依赖方向、二阶语义 | 3.1 Pro High |
| 独立 adversarial review | 3.1 Pro High 略优 |
| 教学题与业务深层设计 | 本次未证明 Pro 必然更强,需人工审校 |
| Agent 收敛与收尾治理 | Flash 出现过挂起进程;3.1 Pro 出现过 Git 违约与过早 READY;均需外部门禁 |
所以我的实际使用策略已经发生变化。我不会再默认“复杂任务全部上 Pro”,也不会假设任何单一模型能独立无缝闭环:
Pro 建 Reference,Flash 做批量扩展,Pro 做 adversarial review,人类工程师做最终边界审校与门禁治理。
这不是因为 Flash “便宜”,而是因为它在已经明确的工程合同下,coding execution 确实足够高效;这也不是认为 Pro 无所不能,而是把它配置在最能发挥二阶抽象价值的工位,同时由人守住业务逻辑与架构底线。
十一、3.5 Pro 的“难产”能不能说明 3.8 Flash 就是它改名而来?
社区里容易出现一种推断:3.5 Pro 迟迟没有正式公开发布,而 Flash 连续升级到 3.8,于是猜测“Pro 的成果是不是直接塞进 Flash 了”。
这里需要把公开事实与未经证实的推测明确区分开来:
- 官方发布与 Benchmark 事实:Google 在 2026 年 5 月 19 日发布 Gemini 3.5 Flash 时,官方披露其在 Terminal-Bench 2.1、GDPval-AA 以及 MCP Atlas 等 Coding 与 Agentic 评测集上的表现均已超过此前的 3.1 Pro;同篇官方文章表示 3.5 Pro 已进入内部测试并计划次月推出。需要明确说明:这些数据属于 Google 官方披露的 benchmark 与产品发布事实,不代表本文在真实工程仓库中的单一实测,也不能据此直接推导 3.8 Flash 在所有任务上都必然强于 3.1 Pro;
- 截至 2026-09-11 的现状:截至本文撰写时,Google 官方公开模型列表中仍未上线正式的 3.5 Pro,而 3.8 Flash 已于 9 月 2 日正式发布;
- 推测与事实的界限:目前没有任何官方材料支持“3.5 Pro 最终直接改名为 3.8 Flash”,因此本文不把这一社区猜测采纳为模型谱系事实。
对开发者而言,与其花精力揣测厂商的模型谱系,不如把注意力放在真实工程仓库的交付结果上——严谨的工程实践只对可验证的产出负责。
十二、真正改变我的,不是模型排名,而是 Agent 工程方法
这轮测试最后产生了一个比“谁更强”更重要的结果。
我们原本只是想测试 Gemini,最后却把 ArchSight Science 一直偏薄弱的学习层做出了两个真正可体验的 Reference:
- M0401:函数平移的符号直觉;
- P0402:滑轮组负载与机械效率。
我自己实际走完流程以后,明显感觉它比单纯“读讲义 + 自由调参数”更像学习:
先形成判断
→ 看系统证据
→ 自己动手改变条件
→ 再解释发生了什么
→ 最后迁移到一个新问题
这也让我意识到:下一步不能靠人工一个个给 444 个实验写任务。真正可扩展的方式应该是:
人定义 Reference、质量合同、候选筛选规则和 Review 门禁;Agent 自己扫描目录、排序高价值经典实验、逐批实现并更新任务注册表。
模型能力越强,工程管理反而越重要。因为决定最终产出的,越来越不是“哪个模型排行榜高两分”,而是:
有没有一套让不同 Agent 持续交付正确结果的系统。
在这次实战后,这套 Guided Handoff 模式已经正式合入主分支,成为 ArchSight Science(筑见科学实验室) 交互探索体系的一部分。
作为一线开发者,这也是我做这个科学实验平台最有成就感的地方:它不是一个简单的静态公式板,而是包含约 444 个数学、物理、化学交互实验,且具备确定性科学仿真内核的探索空间。
以前学习者调参数,常常调完不知道说明了什么;而现在,有了这种由真实代码与物理证据链严格约束的“引导式接管”,科学概念终于不再只是死记硬背的定理,而是可以在浏览器里亲手验证、亲眼看见认知冲突被打破的过程。
如果大家也对交互式科学探究、数理化可视化或者这次实战打磨出的 Guided Handoff 体验感兴趣,不妨在网页中检索体验 ArchSight Science。在真实运行的环境里操作一下 M0401 和 P0402,或许你也会对这种经过严格工程门禁检验的科学交互体验,产生更具象的体会。
结论
如果用一句话总结这次 Gemini 实测:
3.8 Flash 的 coding execution 很强;3.1 Pro 在新问题建模和二阶 review 上仍有独特价值;但两者都不是无需治理的 autonomous engineer。
两者的优势工位不同,暴露出的故障模式也不同:Flash 曾在长时间前台运行中挂起,3.1 Pro 曾出现过规则违约与过早放行。脱离了具体的工程治理体系——包括共享工作树纪律、进程看门狗、状态证明链、Git CI 门禁以及最关键的人工终审——任何单一模型都无法在严肃生产代码库里可靠闭环。
我目前的实际分工体系已经固化为:
新问题 / 新 Pattern 探索
    3.1 Pro High
        ↓
成熟 Pattern 的跨领域实现与测试扩展
    3.8 Flash High
        ↓
独立 Adversarial Review
    3.1 Pro High
        ↓
业务语义与证据链最终门禁
    Codex / 人类架构师
这次实战给出了一个长期的工程判断:
未来 Coding Agent 在工程落地中的关键,不在于厂商发布会公布的单项指标或公开 Benchmark 榜单。
在真实软件研发体系中,真正决定交付质量与工程效率的,是由模型能力、Agent Harness、上下文治理、自动化测试网、Git 状态管理、进程监督机制、额度风控与人工 Review 成本共同构成的工程管理系统。
模型本身不是生产力,能让不同特性的模型在严格治理下持续交付正确软件的系统,才是真正的生产力。
参考资料
以下资料均可按标题检索:
- Google AI for Developers, Gemini 3.8 Flash (2026-09-02)
- Google AI for Developers, What's new in Gemini 3.8 Flash (2026-09-02)
- Google Blog, Introducing Gemini 3.8 Flash and 3.8 Flash Cyber (2026-09-02)
- Google Blog, Gemini 3.1 Pro: A smarter model for your most complex tasks (2026-02-19)
- Google Blog, Gemini 3.5: frontier intelligence with action (2026-05-19)
说明:本文中的工程评价与模型分工结论来自 ArchSight Science 单一真实项目样本,不等同于通用 benchmark;Antigravity 的额度变化仅作为使用现象记录,本文不据此推断 Google 未公开的具体 token/quota 计费算法。
关注我们
欢迎搜索并关注 筑见实验室,获取更多建筑 AI、结构计算与工程数字化实践: