一次 AI 长标书审核,约 5 秒就留下了两条冲突线索。结果却仍然是失败。
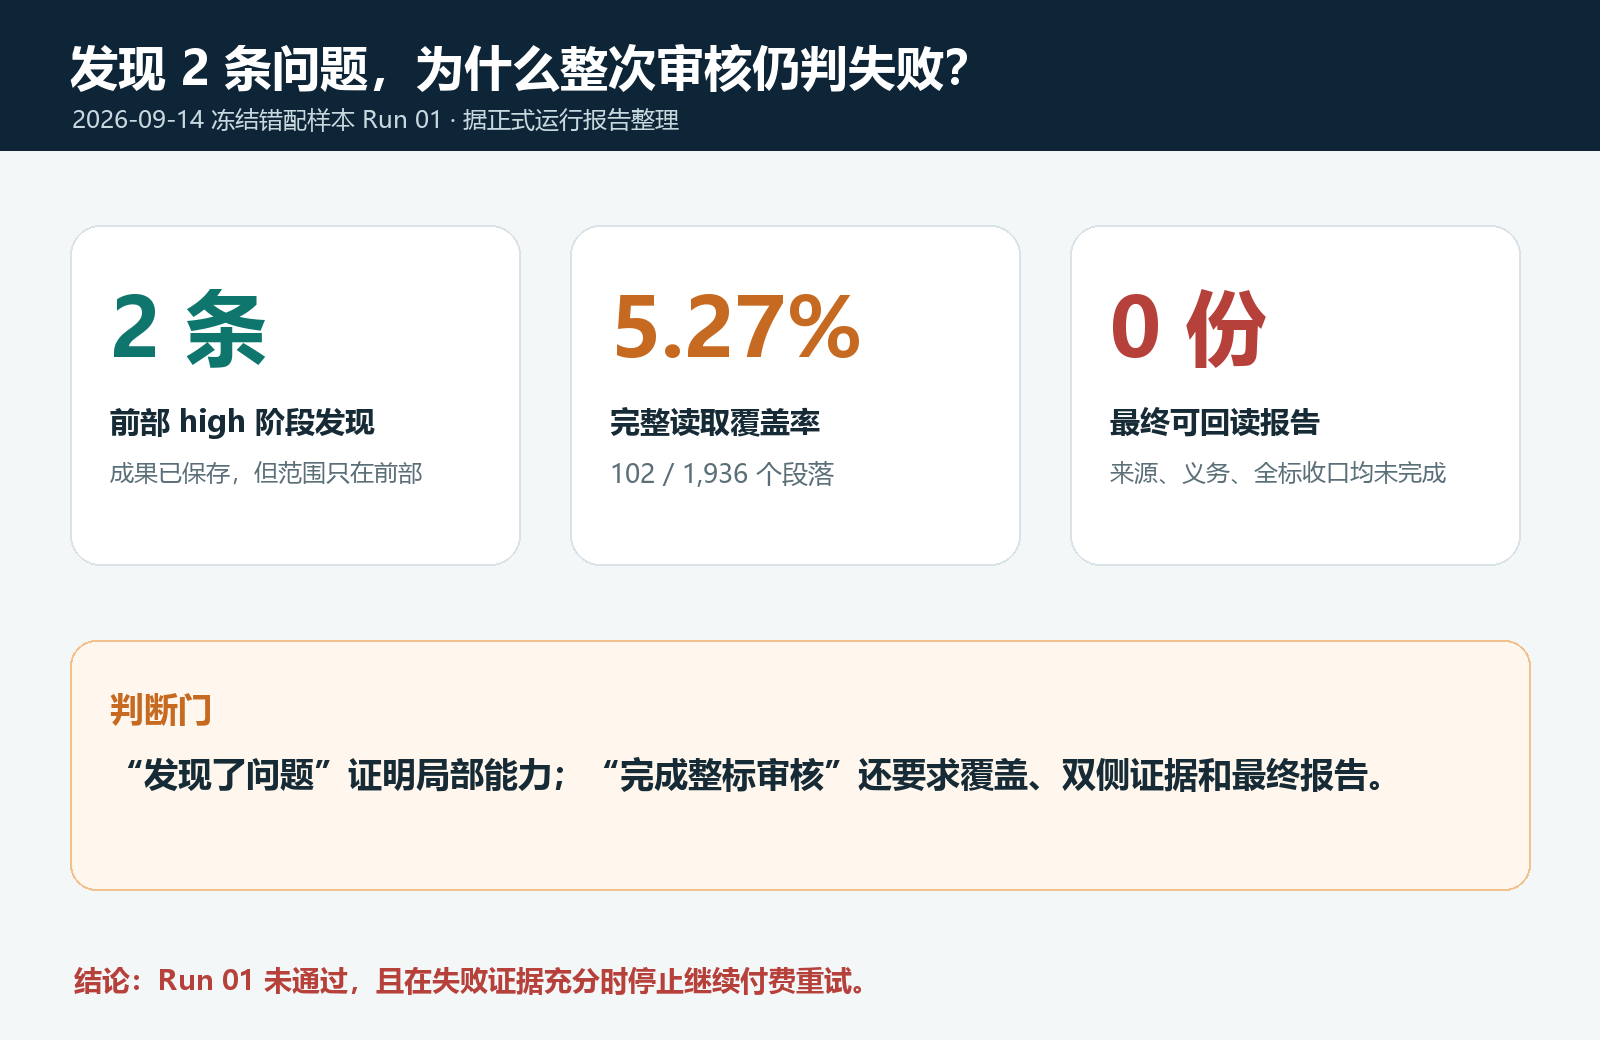
2026 年 9 月 14 日,我们用正在研发的本地 AI 标书工作台做了一次只读对照验证:3 次真实模型请求,供应商账本累计 43,145 Token,保存 2 条阶段发现;工具记录的段落读取覆盖率为 5.27%,没有最终报告。
这里的“真实”,指模型请求和客户端任务链实际运行了。材料是人工植入冲突的冻结样本,不是真实客户项目;本轮也没有改写标书或检验 Word/WPS 交付。
局部发现有价值,但预定的整标只读审核任务没有完成。
两条线索,证明了哪一部分能力
模型在样本前部识别到旧项目名称和旧地点残留,保存为两条阶段发现。它们来自同一个前部位置,并非两个独立项目。系统将其标为高优先级,但这个标签本身不代表专业人员已经确认风险等级。
首批成果在任务启动后约 4.9 秒保存。这说明该样本的前部冲突能较早暴露,也说明成果可以在任务结束前落盘。它不说明全篇处理只需要几秒,更不是稳定性能基准。
冻结样本还在中部和后部预设了冲突。本轮没有读到这些位置,来源材料和逐项审查要求也没有处理完。因此,已有线索可以交给人继续核对,却不能被包装成整份文件的审核结论。
5.27%究竟是什么覆盖率
本次文档解析得到 1,936 个可审段落,范围包含正文以及页眉、页脚。工具账本中,102 个被登记为完整读取:
102 / 1,936 ≈ 5.27%
这是按段落个数计算的读取覆盖率。它不是页数比例,不代表按字数加权的覆盖,也不是正确审核率或问题召回率。段落有长有短,“被读取”与“其相关要求已经判断正确”还隔着一步。
对这次整标任务,至少需要分别记录文档读取范围、来源资料覆盖、逐项要求的处理状态和最终报告状态。表格、图片等内容是否进入可审范围,也必须由解析能力与任务约定交代,不能仅凭一个段落比例推定全部覆盖。
假如任务只要求核对指定章节,覆盖分母应按事先约定的范围计算。本轮目标是整标审核,不能在失败后缩小范围,再把前部成果解释成整体完成。
不用有争议的分数支撑失败结论
冻结样本设有 4 项正例。本轮识别到前部 2 项的冲突语义,中后部 2 项未覆盖。这是一份小样本的位置与发现记录,不能据此推导真实项目中的稳定召回能力。
原运行报告记录了严格 0/4 与语义放宽 2/4 两种口径;后续复核指出,要求某个特定来源回执字段,是否属于试验前冻结的评分规则,还需核对原件。
因此,这里不把任何一个总分作为已经解决争议的质量结论,也不事后改动判分规则。可以确定的失败依据已经足够:约定范围未完成,任务因输出截断结束,且没有最终报告。
来源定位仍然值得补齐。对新旧项目冲突,应能回到旧稿位置和新要求来源;但“产品今后应具备什么”与“本次原本怎样评分”,必须分开。
第3次响应在哪里被截断
三次请求的供应商账本如下:
| 请求 | 输入 Token | 输出 Token | 合计 Token | 结果 |
|---|---|---|---|---|
| 1 | 7,105 | 439 | 7,544 | 保存 2 条阶段发现 |
| 2 | 10,684 | 151 | 10,835 | 继续取证并保存上下文 |
| 3 | 23,742 | 1,024 | 24,766 | 响应被截断,任务失败关闭 |
| 合计 | 41,531 | 1,614 | 43,145 | 未完成整标审核 |
这些是累计请求用量;后续请求可能再次携带上下文,不能把输入 Token 合计当成已经读过的独立文档长度。也不能直接按 5.27% 的段落比例,线性外推完整审核成本。
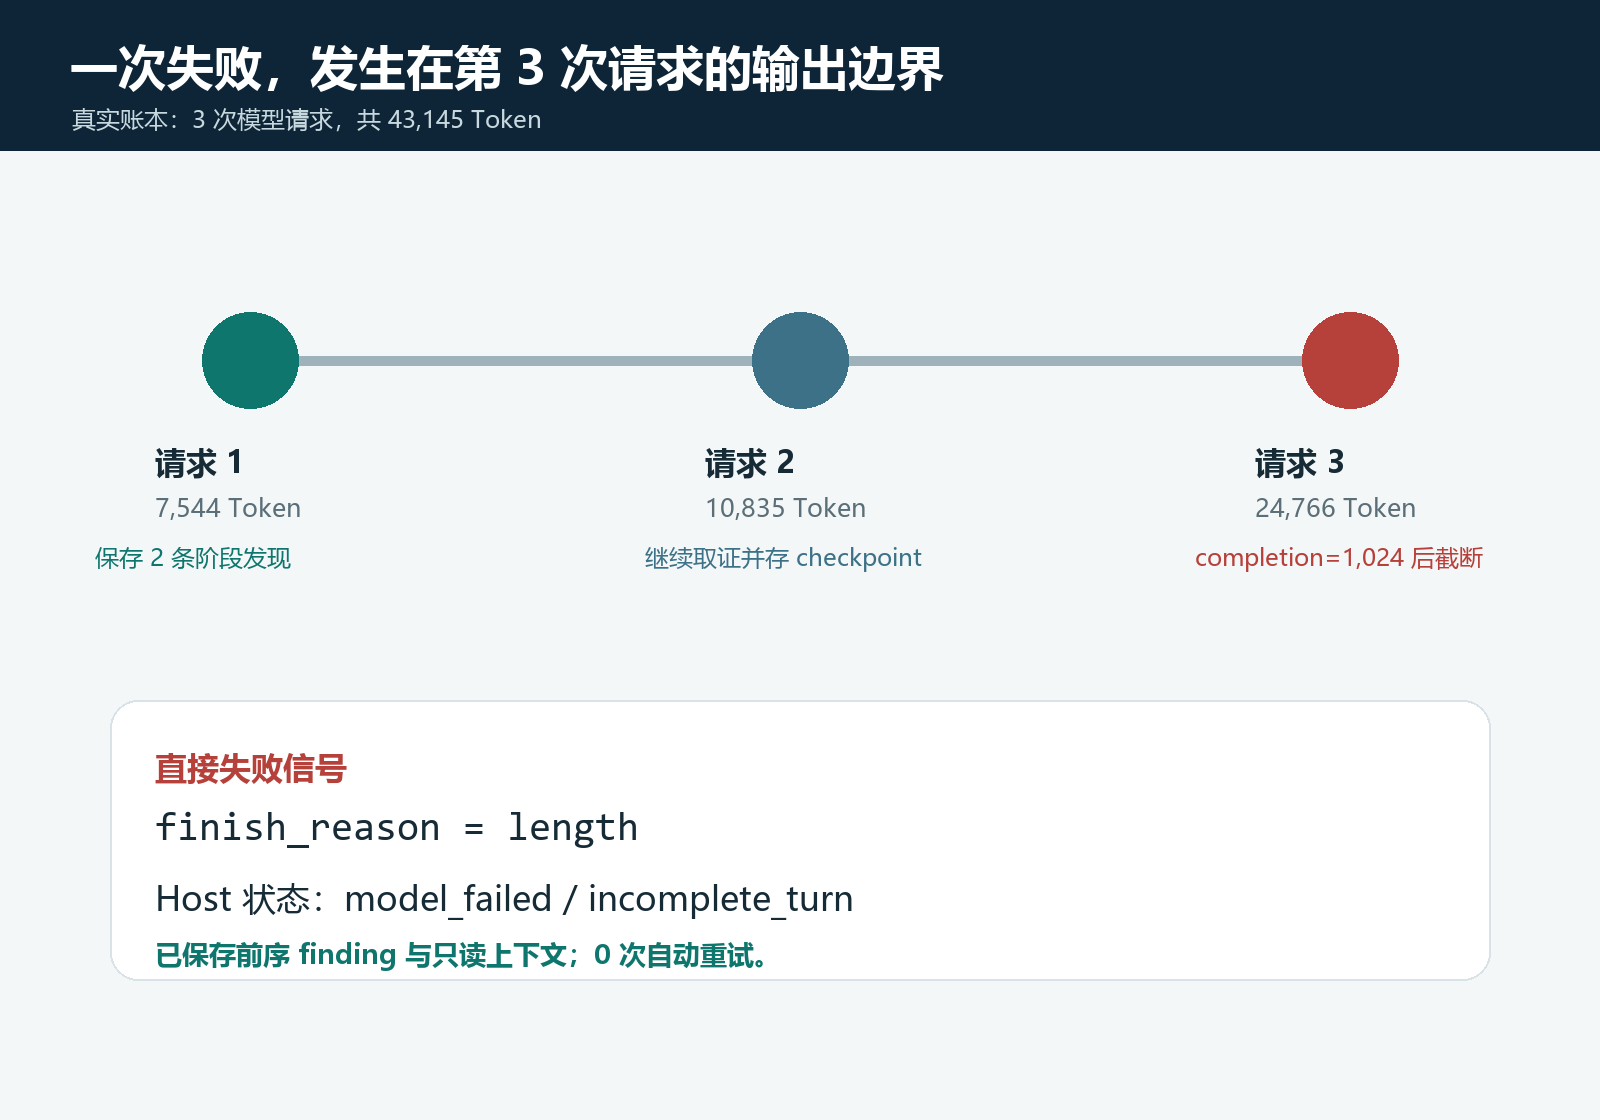
第 3 次响应的输出用量为 1,024 Token,返回 finish_reason=length。这与报告所核对的单次有效输出上限一致。宿主在执行结构化工具调用前拒绝不完整响应,以 model_failed / incomplete_turn 结束任务。
这个事实能定位直接失败环节:本轮响应未能在有效上限内完整返回。它不能单独说明原本还需要多少 Token,也不能证明模型当时尝试输出了工具允许的最大条目数。
代码复核发现,输出额度与允许的登记批量、字段长度没有协调好。这是有依据的修复方向;具体截断位置和待登记内容仍应回到冻结响应核对,不能声称完整根因已经穷尽。
保存阶段成果,不等于已经证明可以恢复
本轮没有自动重试、上下文压缩或模型路线切换,三项计数都为 0。系统保留了两条阶段发现和最近一次已保存的审核上下文,也就是供后续核查的检查点。
在输出容量尚未协调、且已满足本轮停止条件时,暂停继续付费是合理决策。但一次运行不足以估计“重试大概率仍失败”,更不能把同样配置下每一次失败都说成必然。
还要分清“保存了”与“恢复成功”。本轮没有实际验证关闭重开、重新授权之后,能否正确复用这些检查点。后续复核还发现,授权记录变化可能影响恢复绑定;已有文件落盘,并不足以证明整条续作链可用。
停止保护了已有成果和剩余额度;它没有把失败的整标任务变成成功。
完整性要检查,准确性也要同时检查
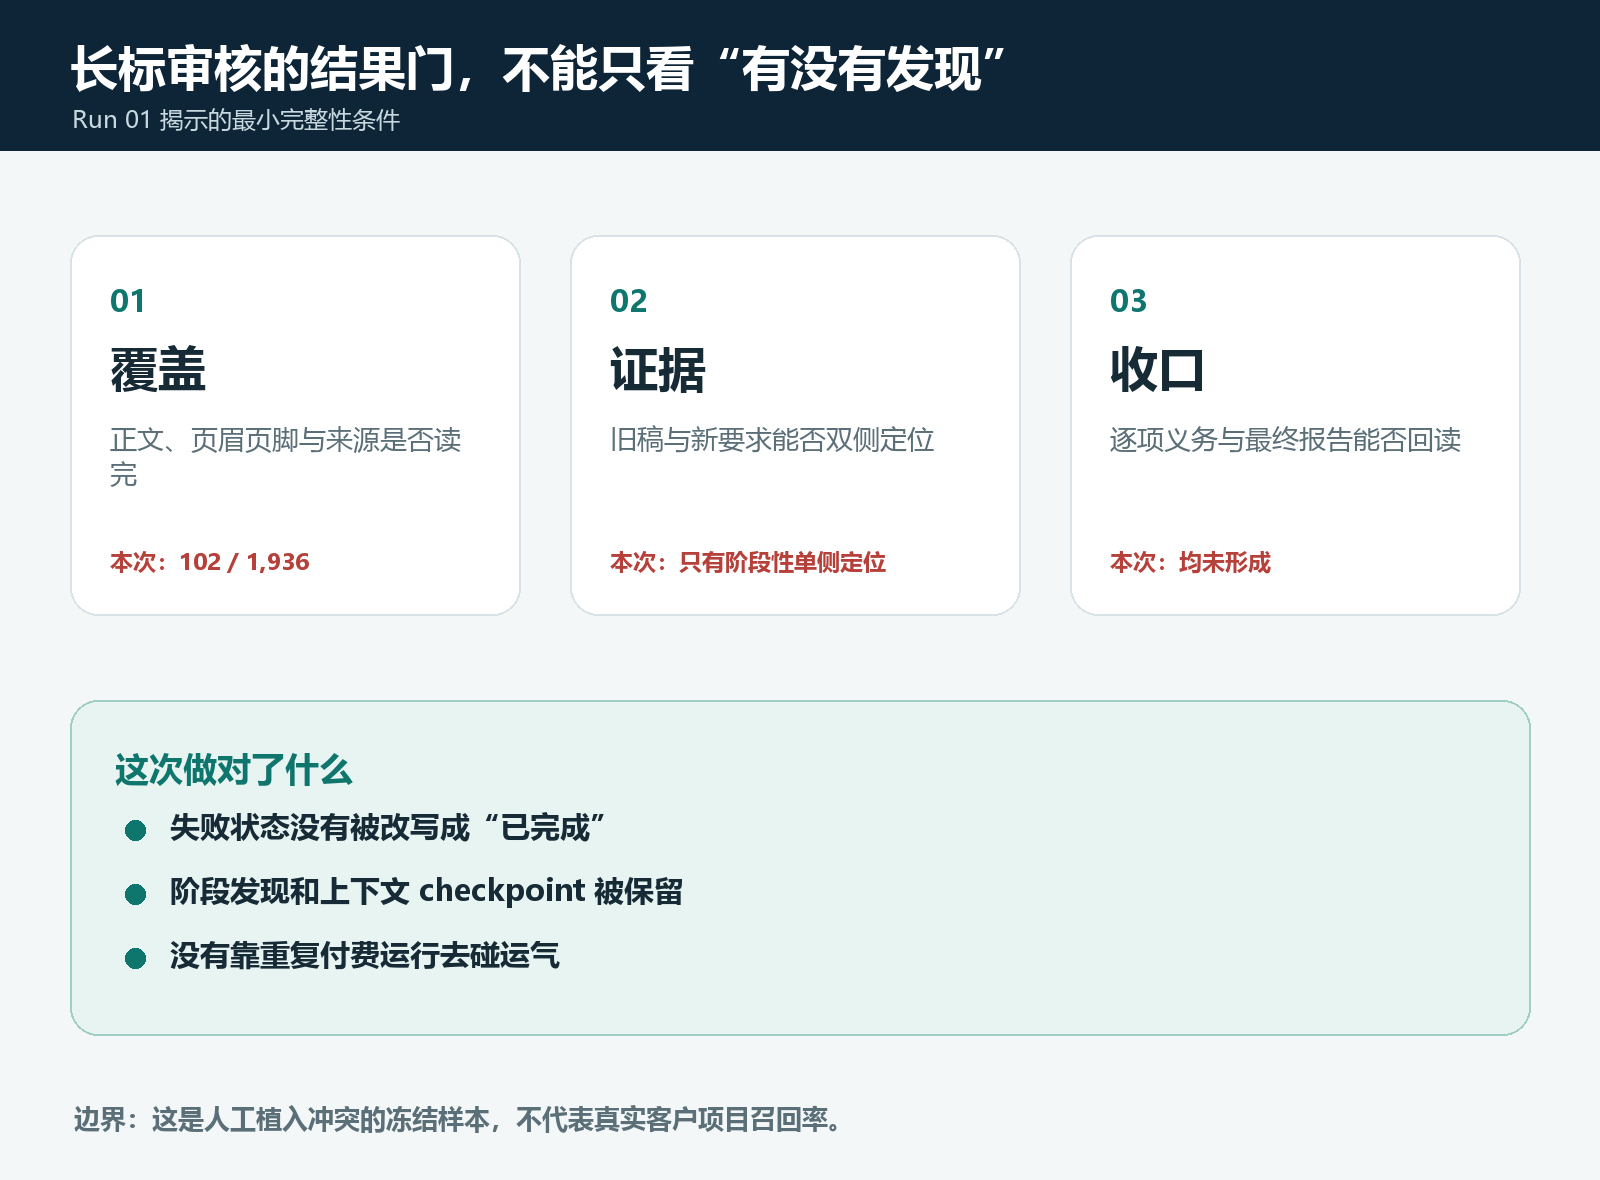
对这类只读对照任务,可以先问三个问题:约定范围处理完了吗?关键冲突能定位到旧稿和新要求两侧吗?逐项要求的状态与最终报告能否保存、重开、复查?
这是结果完整性的检查。对于非冲突类问题,证据应按问题类型要求提供,不必机械套用“两侧来源”;双侧定位也不自动证明引用内容支持结论,还需核对版本和适用性。
即使三项齐全,也不能据此宣布审核可靠。误报、漏报、未知信息处理和人工复核同样需要评价。特别是未覆盖区域,应写“未审核”或“未完成”,而不是默认“没有问题”。
准确性指标从第一轮试验就应记录,用于定位缺陷;不必等完整流程通过后才讨论。只是局部指标再好,也不能代替整标任务的完成证明。
下一轮应怎样验证改进
修复方向不应只有“提高输出上限”。还应让单批登记数量、字段长度和输出预算相互匹配,让完整的小批结果能够持续保存,避免最后一轮重新抄写所有历史发现而再次超限。
下一次验证应继续按冻结的样本和判分规则检查,并记录哪些区域未读、哪些要求未完成。对前后对比,代码、配置、输入和评分口径的变化都要说明;不能把更换样本或放宽标准后的结果,当成原缺陷已经消失。
控制样本、应保留未知的信息,以及失败后的成果复用,也各有验证任务。本轮控制样本未发起付费全篇审核,不能据此给出整篇误报率;要判断结果是否稳定,还需要后续重复运行。
这些是下一轮的验证要求,不是本文已经取得的成果。代码修复、零付费回归与真实模型复测是三类证据,不能相互替代。
工作台仍在研发,本次结论有明确范围
AI 标书工作台目前没有可供公众直接试用的正式版本。
本轮通过 Electron 本地客户端既有的任务入口运行,但没有逐步点击全部桌面按钮,因此也不宣称人工桌面交互全链已经通过。本文只复盘 Run 01,不用后续修复提交代替新的付费实测结果,更不据此宣称产品已可交付。
对实际编审人员,这次失败最值得留下的是一种要求:系统给出问题时,也应交代检查范围、证据和未完成项。关键结论仍需专业人员核实;后续生成修订、人工采用和 Word/WPS 保存重开,还应分别验证。
两条有价值的线索可以保留。尚未完成的整标审核,也必须如实保持未完成。
关注我们
筑见实验室(ArchSight Labs)关注科学学习、建筑工程、软件架构与 AI 实践,持续用内容、开源和产品实验,把复杂问题转化为可理解、可验证、可复用的能力。